影片生成模型一次只處理一個鏡頭。同一隻狗在第三鏡與第三十鏡是否為同一個個體,街邊的柱子在畫面左還是右,模型不會自行記得。這些條件要在生成之前定稿成參考資產與文字規則,再逐鏡附上。本文說明這套前置作業的做法,取材自為台灣防止虐待動物協會製作的宣導短片,整體流程見動物保護宣導短片的專案做法;製作範圍與服務內容,見 AI 影片製作。
跨鏡一致性要在生成之前處理
跨畫面維持同一主體,在研究上是公認的難題。Tewel 等,2024指出,文字生成圖像時,跨越不同提示詞維持同一主體並不容易,並提出免訓練的做法;Zhou 等,2024的 StoryDiffusion 則針對長序列的圖像與影片處理主體一致性。
這些做法都發生在模型內部,委製端與製作端無法改動。能掌握的是輸入端:同一份定裝圖、同一張空間基準圖、同一段風格文字,每一鏡都使用同一版。Seedance 1.0 技術報告(Gao 等,2025)是這類影片生成模型的公開文件之一。實務上,這類模型的輸入除了文字,還可以附上參考圖與參考影片,製作端的工作是決定每一鏡附什麼、各自管什麼。
角色定裝圖:四視圖、服裝狀態與逐條規則
每個角色先出定裝圖,同一角色的四個視角排在一張圖上,讓後續每一鏡都有正面以外的角度可對照。
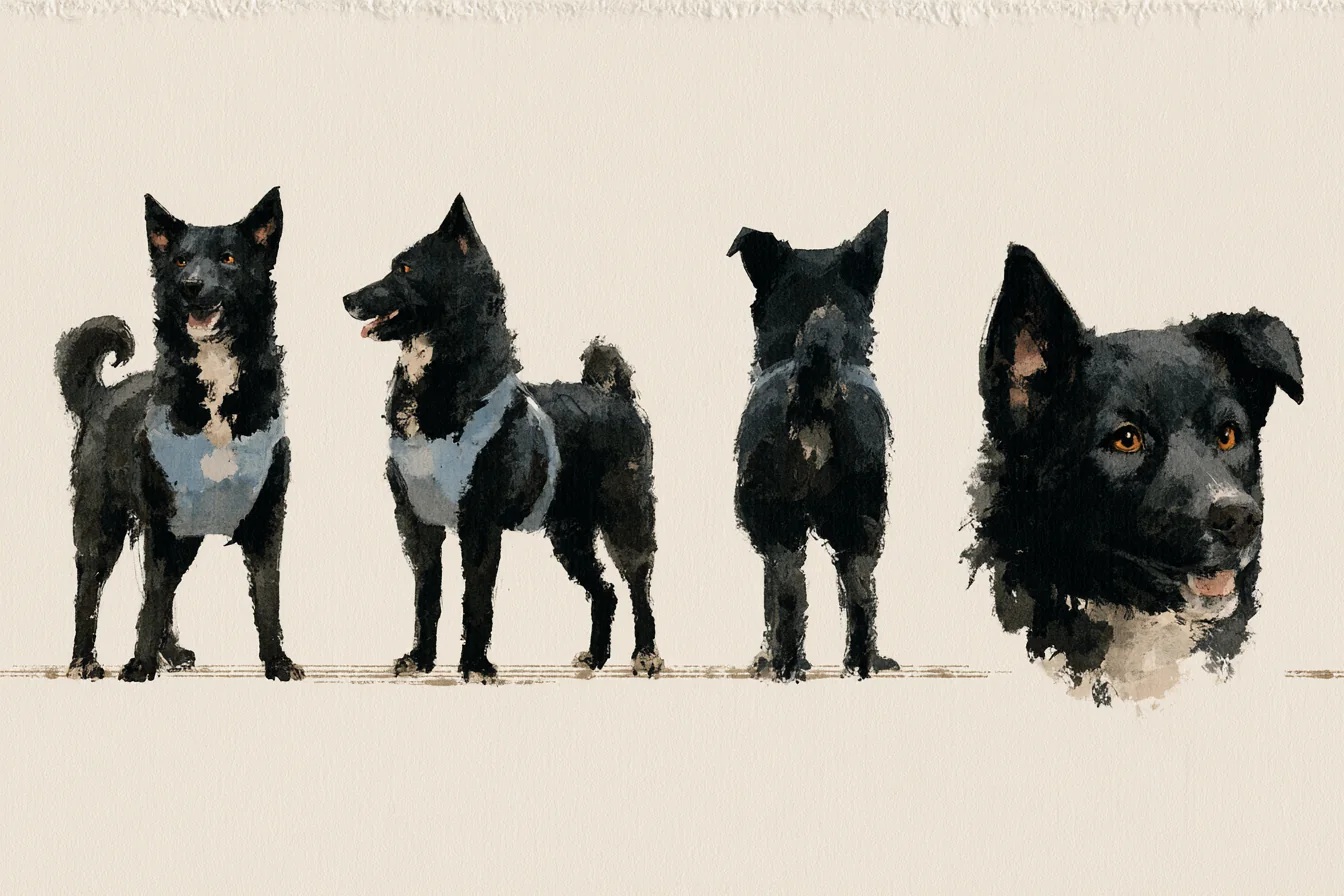
同一角色依服裝狀態拆成獨立定裝。被拴期戴項圈,獲救後換淺藍胸背帶與布質牽繩,兩個狀態各一張,不在同一張圖上修改。服裝變化本身承載敘事,不交給模型自行決定。同樣的拆法也適用於需要多組造型的活動角色,可參考大型活動的角色系統。
角色規則寫成逐條可檢查的句子,每一條都能對著畫面回答符合或不符合:
- 穿戴位置:項圈或胸背帶與定裝圖一致
- 頸部淨空:胸背帶狀態下頸部沒有多餘的物件
- 牽繩材質:布質牽繩,不是金屬鏈
- 眼睛:整顆琥珀色,沒有眼白
「看起來溫柔」這類形容無法檢查,不寫進規則。規則只保留觀看者在畫面上看得出來的項目,逐鏡檢查才做得完。
場景的空間基準圖:風格基準與空間基準分開
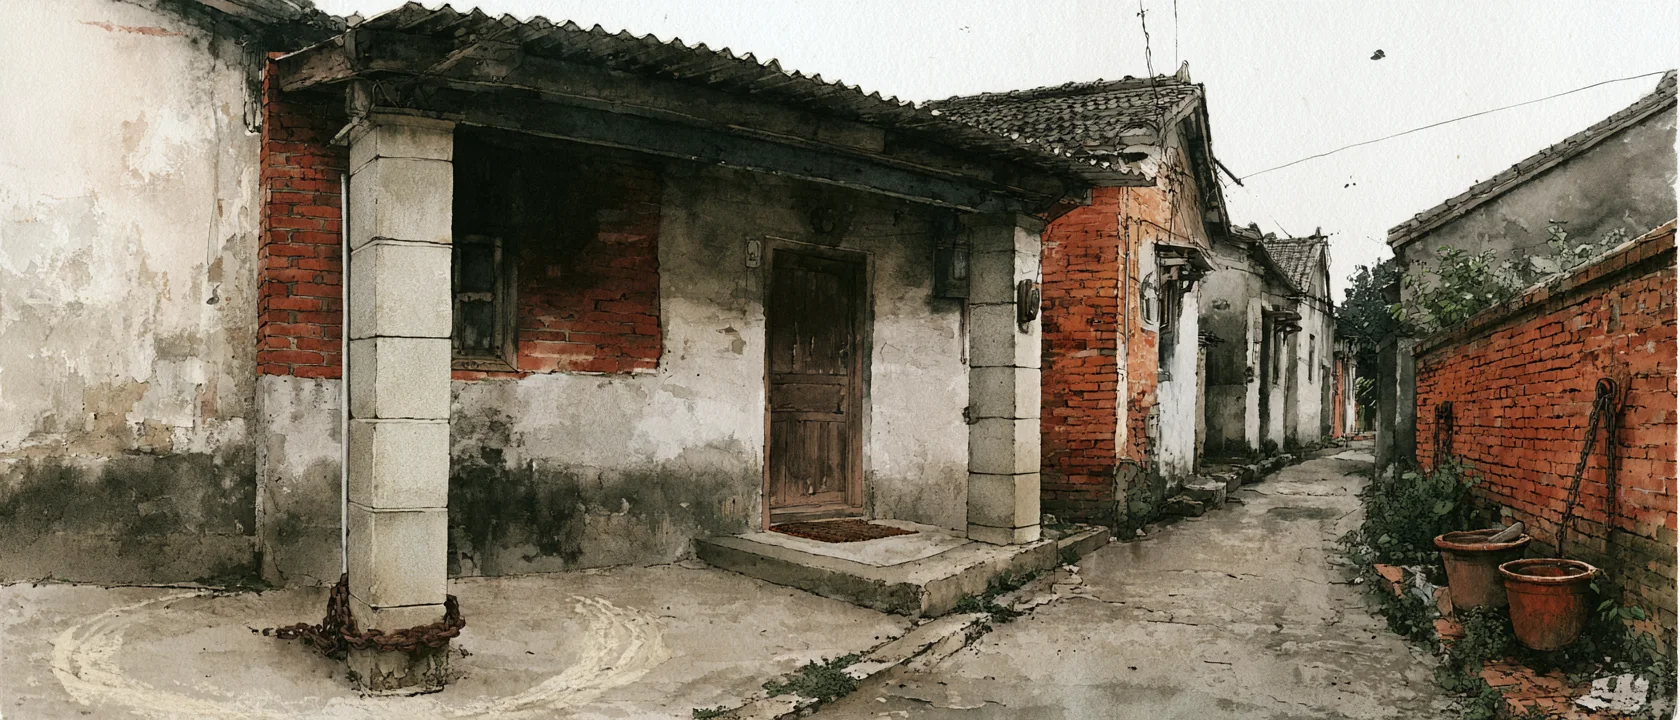
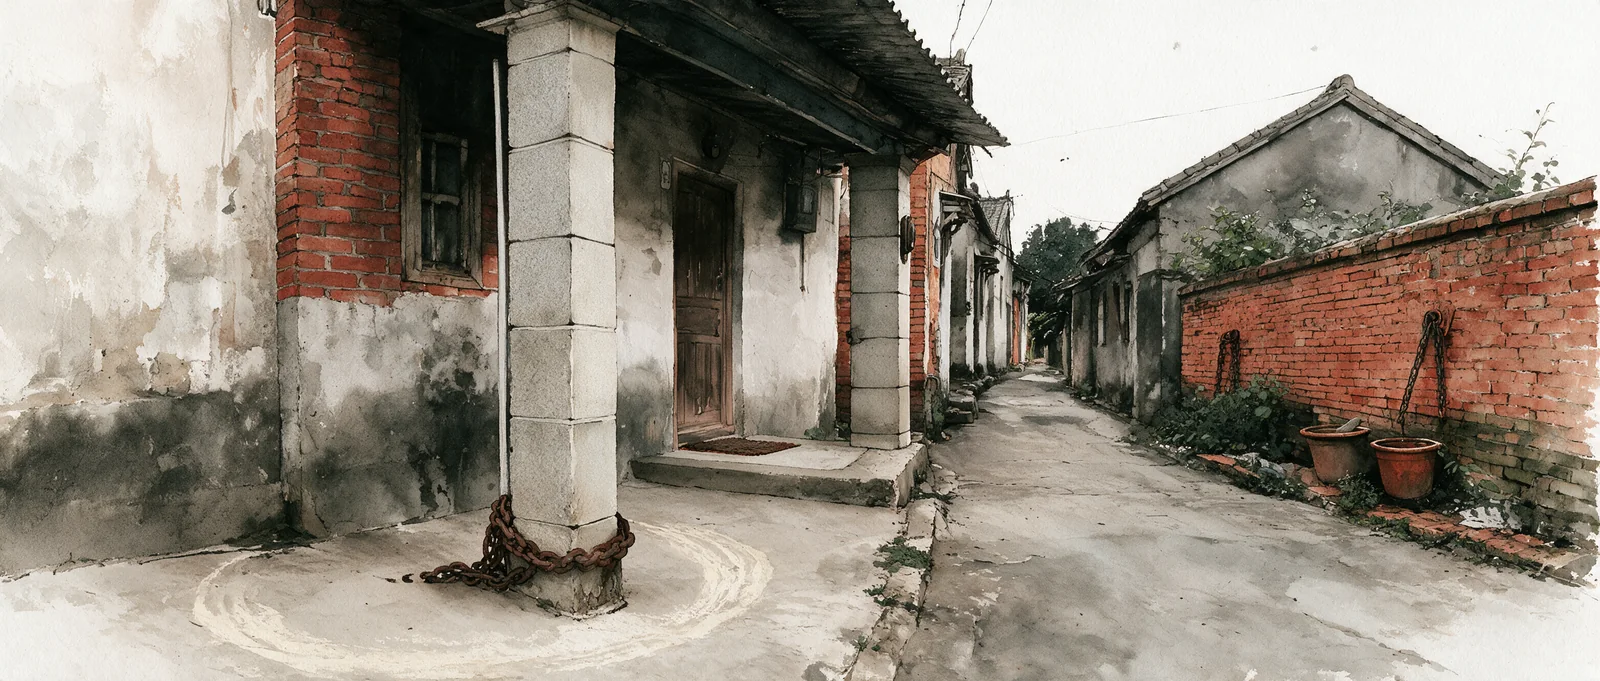
場景用兩種圖,分開指定。風格基準圖是整條街廓的母圖,決定筆法、色調與地點全貌;空間基準圖是某一個鏡位的場景板,決定該處的幾何。分開指定後,更換場景板不影響筆法,調整筆法也不動到幾何。
空間規則另外寫成文件,把圖上看得到的關係變成可對照的句子:
- 騎樓外緣是花崗石柱,鏈條纏在最外側那根柱的底部,弧痕以柱基為圓心
- 木門在內側牆,位於柱子的斜對面
- 所有騎樓鏡頭中,柱子在畫面左、門在畫面右,螢幕方向固定
- 對街的紅磚牆沿巷子斜向延伸
螢幕方向固定的好處在剪接:相鄰鏡頭中的物件左右不翻轉,觀看者不必在每次切換時重新定位。空間基準圖與規則文件互相補充:圖負責外觀,文件負責圖上容易被模型忽略的相對位置,例如誰在誰的斜對面、弧痕以哪一點為圓心。
參考圖在生成時怎麼用:首幀鎖構圖與服裝,影片參考鎖節奏
Ye 等,2023的 IP-Adapter 指出,只靠文字提示難以得到想要的結果,以圖像當提示能補足這一點。影片的做法同理:服裝、構圖與地點用圖來指定,文字主要描述動作、鏡頭與聲音。
參考圖先上傳換成識別碼,生成時以識別碼引用,分鏡表每一鏡列出登場角色。首幀與影片參考的分工如下:首幀是編修過的圖,鎖構圖與服裝;影片參考鎖動作節奏。影片參考的權重會壓過文字對服裝的描述,需要鎖服裝時,以編修過的首幀為準,影片參考只給要對位的那一段。首幀與附圖視為同一份唯一事實來源,畫面一切以圖為準,不增不減。
前置資產(定稿後全片沿用)
- 角色定裝圖依服裝狀態各一張
- 空間基準圖某一鏡位的幾何
- 風格基準圖整體筆法與色調
- 規則文件角色規則與空間規則
單一鏡頭的輸入
- 首幀編修後的圖,鎖構圖與服裝
- 影片參考只給要對位的一段,鎖節奏
- 文字提示動作、鏡頭與聲音
影片生成模型
- 生成單鏡影片
留在規則文件逐條規則不送進模型,留作驗收時對照。
示意單一鏡頭的輸入分工,箭頭標籤是跨過邊界的東西。
依模型特性調整拍法
這類模型在幾種情況下表現較不穩定,處理方式是在分鏡階段就調整拍法,讓每一鏡落在模型擅長的範圍內,生成時需要調整的地方就會少很多。依鏡頭內容,可歸納成五條:
- 物件連接處:鏈條與柱子、手與牽繩這類連接關係,用特寫讓連接處出框,遠景中連接點容易漂移
- 一鏡一情緒:多階段的情緒變化拆成多鏡,交給剪接,每個鏡頭只承擔一種
- 情緒戲用中近景以上:遠景只交代位置、距離這類幾何
- 容易出錯的動作只拍結果狀態:解鏈只拍解開後的結果鏡,俯視數到六的鏡頭用定格圖當首幀
- 空景明寫只有場景、沒有任何生物,避免模型自行補上角色
- 分鏡的一拍已有登場角色、場景板與情緒
- 檢查鏡頭內容連接物件、動作過程、情緒、幾何
- 有物件連接關係特寫,連接處出框
- 動作過程容易出錯只拍結果狀態,定格圖當首幀
- 情緒戲中近景以上,一鏡一情緒
- 只交代空間或幾何遠景;空景明寫沒有生物
全片通過條件:逐鏡人工對照規則
Huang 等,2023的 VBench 把主體一致性列為獨立的評估維度,同時指出現有自動指標未必符合人類感知。因此自動指標只當輔助,通過條件仍然是逐鏡人工對照規則文件。
分鏡階段同時產出人讀版與機器讀版:人讀版是劇本,機器讀版記錄每一拍的場景板與情緒,後續每一支生成片段都能對回同一份資料。全片每個生成片段逐一對照幾何、穿戴位置、頸部淨空、牽繩材質與眼睛五項,全部符合才進入剪輯。畫面、字幕與聲音分項檢查,檢查結果再經第二輪覆核,確認屬實才修改。批次產出的檢查方式與這套相近,可參考批次內容的品質關卡。
三支完整影片皆於 Taiwan SPCA 官方 YouTube 頻道公開:危險動物禁養宣導短片、犬貓晶片與寵物登記宣導短片,以及本文取材的水墨宣導短片。
不適合的情況
- 畫面必須與實物逐項對位,例如產品操作示範,這類內容宜用實拍或 3D 渲染
- 專案時程不容許前置資產先定稿與審核,定裝圖與空間基準圖需要在分鏡之前完成
- 內容需要與特定真人外貌完全一致,且取得肖像授權,宜以實拍進行
費用與時程如何隨鏡數與前置資產增減,可參考 AI 專案的費用估算。實際影片的範圍,可聯絡開發團隊討論。